「あなたは専門家です」「プロの編集者として答えてください」。AIへの指示でよく見かける役割指定ですが、毎回付ける必要があるのか、逆効果という情報をどう受け取ればよいのか、迷いますよね。
「あなたは専門家です」を付けるだけで、答えの正確さが上がるとは限りません。役割を使うなら、どの観点で何を確認し、誰に向けて、どんな形で答えてほしいかまで伝えましょう。話し方が整っていても、事実の確認は別に必要です。


「専門家です」で何を変えたいのかを分ける
役割指定は、担当する作業の視点や、回答の語調・読者層の方向性をAIに伝えるための手段です。専門家の肩書きを書いたからといって、事実や計算の正確さが自動的に高まるわけではありません。
役割を付けたことで「うまくいった」と感じる変化には、いくつかの種類があります。まずは、自分が何を変えようとしているのかを分けて考えてみましょう。
| 変えたいもの | 指示へ書く例 | 確かめること |
|---|---|---|
| 事実・計算の正しさ | 対象資料、対象時点・条件、記載がない場合の扱い | 原資料や計算と一致するか。役割の有無だけでは判定しない |
| 語調・対象読者 | 初心者向け、用語に短い説明、落ち着いた語調 | 想定読者が理解できるか、指定した語調になっているか |
| 視点・担当作業 | 編集の観点から、主張と資料の対応を整理 | 必要な論点が揃っているか。専門家の実査と取り違えない |
| 回答形式 | 結論・根拠候補・未確認点の3項目 | 必要項目が含まれているか、長さや形式が使いやすいか |
語調や対象読者、回答形式は、指示と出力を照らし合わせるだけで意図どおりか判断しやすい項目です。一方、事実や計算の正しさは、肩書きの有無にかかわらず、元の資料や計算式と突き合わせて確認しなければ分かりません。
「専門家と書けば全体が良くなる」と期待するのではなく、自分が今どの項目を変えたいのかを意識することが、指示を直す第一歩になります。
研究が調べたのは、どのモデルのどんな回答か
インターネット上では「役割指定は意味がない」「いや、劇的に改善する」といった相反する意見が見られます。情報が食い違うのは、それぞれの研究が「どのモデルを使い、どんな課題で、何を測ったか」が異なるためです。
事実問題では、役割指定による安定した改善は確認されていない
選択式の問題で知識の正確さを測り、役割指定による正答率の安定した改善は確認されなかった研究があります。
EMNLP 2024に採録されたZhengらの研究(When “A Helpful Assistant” Is Not Really Helpful)では、FLAN-T5、Llama 3、Mistral、Qwen2.5の4系統のモデルを用い、幅広い知識を問う選択式ベンチマーク(MMLU 2,410問)に対して162種類の役割を指定し、正答率を比較しました。モデルに応じた入力形式で、システムプロンプトなどに役割を入れた場合と、役割を入れない場合を比べています。
その結果、「You are a {role}」のような役割を指定しても、役割を指定しない場合と比べて正答率の安定した向上は見られず、一部の役割とモデルの組合せでは正答率の低下も報告されています。
ただし、これは「すべてのモデルやすべての作業で必ず逆効果になる」という極端な結論ではありません。また、聞き手側の立場を指定した場合(「You are talking to a {role}」)との差も小さく、文章の表現力や語彙の調整力を測った実験でもありません。
少なくとも、専門家の肩書きを一言加えるだけで事実の正答率が確実に上がるわけではない、という点はおさえておきたいところです。
専門家像を使って改善した報告は、手順と評価が異なる
一方で、「専門家設定によって品質が向上した」とする報告もあります。前述のMMLUの選択式正答率とは、プロンプトの手順や評価指標が異なる点を見てみましょう。
| 研究 | 主な対象モデル | プロンプトの手順 | 評価方法 |
|---|---|---|---|
| ExpertPrompting(Xuら、2023年の研究、参照版は2025年) | 回答生成はGPT-3.5-Turbo(2023年5月時点)。LLaMA 7Bを使った学習後評価は別に実施 | 質問に適した専門家像を生成させ、その設定をもとに回答させる | Alpacaから抽出した500件について、GPT-4で通常の回答と比較 |
| Multi-expert Prompting(Doら、2024) | gpt-3.5-turbo-0613、Mistral 7B-Instruct v0.2 | 専門家ごとに回答を生成し、7つの作業で集約・選択する | TruthfulQAは調整済みChatGPTによる真実性判定、FactualityPromptは固有表現の誤り、ExpertQAは回答同士の比較など |
これらの研究は、指示文の冒頭に「あなたは専門家です」と一行添えただけの実験ではありません。詳細な専門家像を手順を踏んで作成させたり、複数の視点から出た回答を別の工程で集約したりする丁寧な設計を行っています。
回答の比較、真実性の判定、事実性のエラーなど、測っているものは研究によって異なります。改善の報告を読むときも、自分が求めている「読みやすさ」や「事実の正しさ」と同じ指標なのかを確かめることが大切です。
現在の公式ガイドは、役割や目的を具体的に伝える案内
各AIの開発元が公開している公式ドキュメントでも、役割の活用法が案内されています。以下の公式案内は、2026年10月21日に確認しています。
- Anthropicの Prompting best practices では、システムプロンプトで役割を与えることで、回答の振る舞いや語調を用途に合わせて整えやすくなると説明されています。
- OpenAIの Prompt engineering でも、developerメッセージでAIの立ち位置や目的、語調を定め、その後に具体的な指示や文脈を与える構成が推奨されています。
- Googleの Prompt design strategies でも、具体的で明確な指示、制約条件、出力形式の指定が重視されています。
公式の案内は、特定モデルの性能スコアを競う実験ではなく、実務で意図どおりの出力を得るための設計指針です。また、APIのシステム設定と通常のチャット画面の入力欄では指示の反映のされ方が異なるため、チャットの冒頭に一行添えるだけで公式の手順と同じ条件になるとは言えません。
ここまでを踏まえ、この記事では役割を、立場・語調・観点を具体的に伝えるために使うことを勧めます。正答率が上がるという期待と、回答の方向を絞る用途は分けて考えましょう。
肩書きを、担当作業・読者・答え方へ書き換える
指示を直すときは、漠然とした肩書きを削るか残すかにこだわるのではなく、「誰に向けて、どんな作業を、どの資料に基づいて、どんな形式で出力してほしいか」を具体化します。
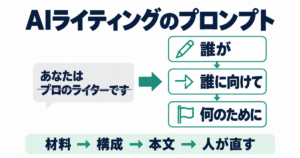
私がAIで文章を書くときに重視しているのも、「誰が・誰に向けて・何のために書くのか」を伝えることです。AIに「プロの編集者です」とだけ伝えても、何を基準にどこまで直してよいのかが曖昧なままだからです。
例えば、新しいサービスの告知文を確認してもらう場面で、指示を書き換えてみます。以下は説明用に作った例で、実際の出力を比較した実験結果ではありません。
変更前:
あなたはプロの編集者です。この告知文をチェックしてください。書換案:
編集担当として、次の告知文を確認してください。
読者はサービスを初めて使う人です。申込みの条件を判断できるかを見てください。
【告知文と、条件を確認できる資料を貼る】
本文はまだ書き換えず、「曖昧な箇所」「資料上の根拠」「確認が必要な点」を表にしてください。
資料にない条件や数字は補わず、根拠が見つからない点は未確認としてください。
書換案では、以下の要素を整理して渡しています。
- 担当作業:「チェックして」ではなく、「告知文の編集確認」として見るべき基準を指定する。
- 対象読者:「サービスを初めて使う人」と明記し、その読者が申込条件を判断できるかという視点を持たせる。
- 必要な材料:告知文だけでなく、判断の根拠となる条件資料を合わせて渡す。
- 変更範囲:「本文はまだ書き換えない」と、依頼する作業の範囲を伝える。
- 完了条件・出力形式:「曖昧な箇所」「根拠」「確認が必要な点」の表として返すよう求め、資料にない情報を補わない条件も伝える。
役割名に加え、「何を根拠に、どこを確認してほしいか」を具体的に伝えるのがポイントです。
文章作成における指示の組み立て方や必要な要素については、以下の記事でも詳しく整理しています。
出力が返ってきたら、確認を2段階に分けましょう。
- 「指定した形式や語調になっているか」(目視で確認しやすい)
- 「挙げられた指摘や根拠が元の資料と一致しているか」(原資料との照合が必要)
専門家らしい落ち着いた口調であっても、事実関係の照合は人が行う必要があります。
追加の言葉より、出てきた答えを確かめる
仕事で使うなら、追加のフレーズを重ねるより、必要な出力を伝え、返ってきた内容を資料と照らし合わせることを勧めます。
よく話題になるフレーズについても、現在の扱いを整理しておきましょう。
- 「ステップバイステップで考えて(Chain of Thought)」について: Kojimaらの研究(Large Language Models are Zero-Shot Reasoners)は、2022年当時の主にtext-davinci-002などを対象に、推論文を生成してから最終回答を取り出す2段階の手順で、一部の推論課題の正答率改善を報告しています。一方、現在のOpenAIの推論モデル向けガイド(Reasoning best practices)では、内部で推論を行うため、step-by-stepの追加指示は不要と案内されています。途中の計算や根拠を知りたいときは、「結論、計算式、確認が必要な箇所を分けて書いてください」のように、必要な出力を具体的に求めましょう。
- 感情的な言葉や「深呼吸して」について: EmotionPromptは、2023年のGPT-3.5-Turboなど6モデルに「キャリアに関わる重要な仕事です」といった刺激を加えた研究です。「深呼吸して」という候補文は、別のプロンプト最適化研究Large Language Models as Optimizersで、PaLM 2系と算数問題などを使った設定に登場します。いずれも特定条件での結果なので、どの仕事にも毎回付ける必須の言葉としては勧めません。
- 複数回の回答や追従への対策: Self-Consistencyは、推論例を与え、多様な推論経路を独立に生成して最終回答を集約した研究です。同じ会話で数回質問したり、1回で3案を書かせたりする方法と同じ条件ではありません。また、ユーザーの意見に回答を合わせる追従性の研究もあります。多数派の答えや肯定的な返事だけで正しいと決めず、根拠となる資料を確かめましょう。
事実確認の具体的な進め方や、対話を通じた指示の修正方法については、以下の記事で扱っています。
まずは手元の指示にある漠然とした肩書きを1つ見直し、「どんな作業を担当し、誰に向けて、どの形式で出すか」を明確に書き換えてみてください。そして返ってきた回答は、言葉遣いの丁寧さに惑わされず、資料と照らし合わせて確かめましょう。